多重免疫荧光(multiplex immunofluorescence,mIF,也常称 mIHC 多重免疫组化)是数字病理与肿瘤免疫研究的核心技术。该技术可在单张组织切片同时检测多种蛋白标志物,输出细胞计数、阳性细胞占比、细胞密度以及每个细胞的二维空间坐标,能够同时解析肿瘤免疫微环境(TIME)的细胞丰度与细胞空间排布两大维度信息,为筛选免疫治疗预测性生物标志物提供强有力工具。但 mIF 数据具有零膨胀、重复测量、图像缺损、批次效应、复杂空间点模式等多重统计学难点,传统统计方法难以适配。本文这篇发表于Cancers的综述“Challenges and Opportunities in the Statistical Analysis of Multiplex Immunofluorescence Data”,系统梳理 mIF 从原始成像、质控、汇总统计建模到空间点过程分析的全流程统计学痛点、可行解决方案以及未来发展方向,同时结合卵巢癌大队列(NHS I/II、AACES)实例进行方法演示,是 mIF 数据分析领域极具参考价值的方法论综述。
mIF 以 FFPE 石蜡包埋组织(组织芯片 TMA 或者整张组织切片)为实验材料,依托多光谱成像(MSI)技术,通过循环染色、酪胺信号放大、光谱解混,将不同标志物荧光信号进行拆分;再借助 HALO、InForm 等软件完成组织区域划分(肿瘤 / 基质)、细胞分割、细胞表型判定,最终输出单细胞水平定量数据。
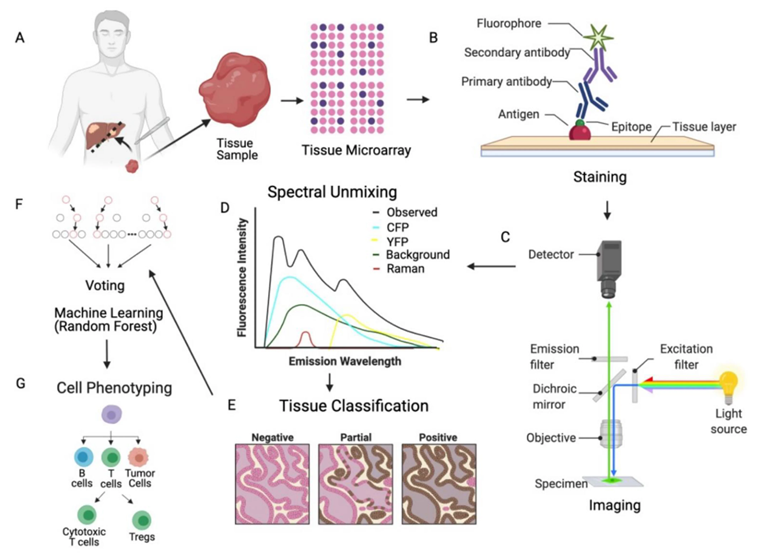
图1 mIF技术与数据生成总流程
上图完整展示 mIF 完整工作流:
- 生物样本:患者活检 FFPE 组织,制备组织芯片 TMA;
- 染色成像:一抗二抗结合抗原,多光谱相机采集不同波长荧光信号;
- 光谱解混(Spectral Unmixing):把混合荧光拆分成各个标志物、背景、拉曼散射信号,消除荧光串色干扰;
- 组织分类:区分肿瘤区域、基质区域、空白玻璃区域;
- 机器学习(随机森林)完成细胞分割、细胞表型注释,区分细胞毒性 T 细胞、调节性 T 细胞、B 细胞等免疫亚群。
最终数据集包含两类核心信息:①汇总统计指标:阳性细胞数、总细胞数、阳性细胞百分比、细胞密度;②空间信息:每一个细胞的 XY 坐标、细胞表型标签。同时拥有丰度信息 + 空间位置,是 mIF 区别于普通 IHC、转录组反卷积的最大优势。
高质量统计分析必须建立在严格质控之上,文章重点指出两大高频问题:细胞表型错配冲突与批次效应,同时还存在组织切片缺损(图像孔洞 holes)、不同标志物面板跨切片无法直接比对的现实困境。
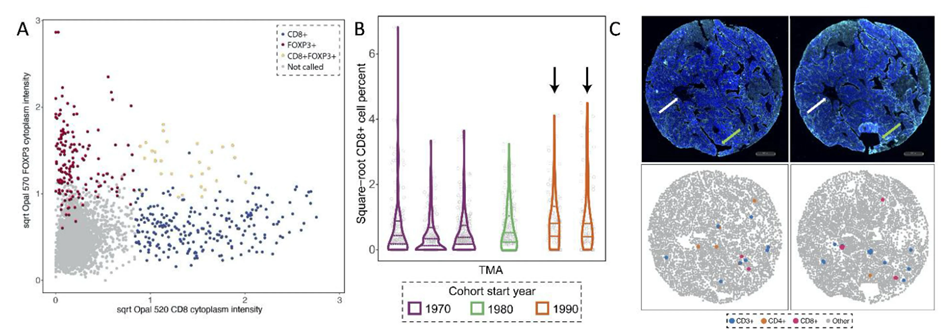
图2 mIF质控典型问题
以 T 细胞分型为例:CD3 为总 T 细胞标记,CD8 标记细胞毒性 T 细胞,FOXP3 标记调节性 T 细胞;生物学上,成熟 T 细胞几乎不会同时高表达 CD8 与 FOXP3。但 HALO 等软件基于荧光强度阈值自动判读,经常出现CD3+CD8+FOXP3+的矛盾细胞表型。
鉴于此,综述给出 3 种解决策略:
- 逻辑过滤:将冲突细胞降级仅保留通用标记(仅标记 CD3+,丢弃 CD8、FOXP3 阳性判定);
- 改进表型算法:利用已知假阳性细胞荧光强度作为判定阈值的监督式表型方法;
- 参考单细胞注释数据库,如 CITESeq 图谱辅助校正细胞分型结果。
mIF 批次来源多样:不同 TMA 芯片、染色时间跨度大(部分样本标本库跨度数十年)、组织样本储存时间差异,会造成相同细胞类型阳性率在不同批次间系统性偏移。
质控实操建议:
- 可视化质控:箱线图、小提琴图、散点图观察阳性细胞比例在不同 TMA、染色批次的分布;
- 实验设计层面:同一个患者全部组织芯放置在同一个 TMA 芯片;TMA 构建时对临床特征、组织年限做随机化均衡;
- 数据分析层面:无法重做实验时,统计模型纳入批次作为协变量校正,或者分层分析验证结果稳健性。
TMA 切片常存在组织脱落、坏死,形成图像 “孔洞 holes”,部分区域完全无细胞,而绝大多数空间统计方法默认 ROI 内均可观测细胞,孔洞会带来严重统计偏倚。
另外,如果不同标志物检测面板使用连续组织切片而非同一张切片,细胞位置无法一一对应,不同面板之间不能直接做共定位分析;即使同一张切片做多轮染色,也会存在标记物遮蔽干扰。因此,不同 marker 面板的空间分析需要分开解读。
完成质控后,最常规分析是探究免疫细胞丰度(计数、百分比、密度)与临床结局、治疗响应之间的关联。mIF 计数数据普遍存在零膨胀、过离散、同一患者多个组织芯重复测量三大统计痛点,不适合直接套用 t 检验、普通线性回归。
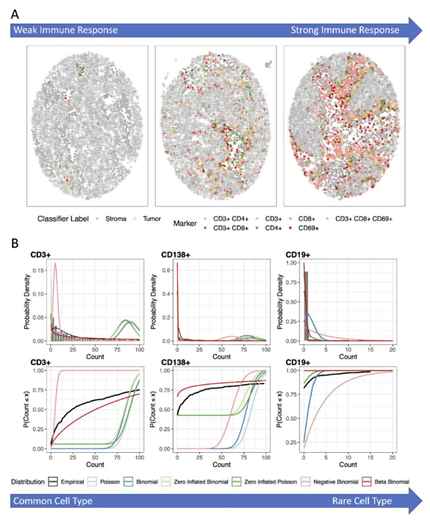
图3 免疫细胞计数分布与模型选择参考
“冷肿瘤” 免疫浸润很低,大量样本目标免疫细胞计数等于 0,造成零膨胀;同时样本方差远大于均值(过离散),违背泊松、二项分布的基础假设。
- 泊松、二项分布:无法处理过离散与零膨胀;适合免疫细胞丰度高、极少零样本的场景;
- 负二项分布、β二项分布:可以处理过离散;适合零样本占比<50% 的细胞亚群,如 CD3+、CD138+;
- 零膨胀泊松 ZIP、零膨胀二项:专门针对大量零值,适合稀有细胞亚群,例如 CD19+B 细胞(大量样本计数 = 0)。
建议:分析前评估各个标志物的分布拟合效果,为不同免疫标记选择最优分布模型,最大化统计检验效能。
研究者常把阳性细胞百分比 / 密度做对数、平方根变换(数据集存在 0 值时只能用平方根变换),改善偏态分布,之后使用 t 检验、线性模型。也常将连续丰度划分为无 / 低 / 中 / 高分组,但分组阈值选择是重大难题:
- 生物学金标准阈值极少(如乳腺癌 ER>1% 判为阳性);PDL1 在不同临床试验阈值从 1% 到 50% 不等,跨研究难以比较;
- “最优截断点” 方法会产生数据窥探(data snooping),容易放大假阳性;仅适合假说产生,必须独立队列外部验证;
- 多重变量分层截断,会造成部分分组样本量过小,统计不稳定。
同一个患者会采集多个组织芯,属于同一受试者的重复观测,观测之间不独立,直接忽略相关性会低估标准误,升高一类错误。
- 优先方案:混合效应模型(广义线性混合模型 GLMM),引入患者随机效应,处理组内相关性;注意检验模型收敛性,GLMM 计算消耗大;
- 备选方案:取同一个患者多个芯的均值做分析。但该方法会丢失组内异质性信息,低估变异,仅适合样本量极小的探索;
- 不推荐:普通重复测量方差分析,无法灵活纳入多类协变量校正。
mIF 最大价值是挖掘细胞空间结构:不仅仅回答 “有多少免疫细胞”,更要回答 “免疫细胞在哪里、哪些细胞互相靠近、是聚集还是分散”。文章把 mIF 空间分析分为三类:基于像素 / 区域方法、最近邻距离方法、空间点过程方法;同时重点指出 TMA 孔洞、稀有细胞、边界效应是空间统计的主要陷阱。
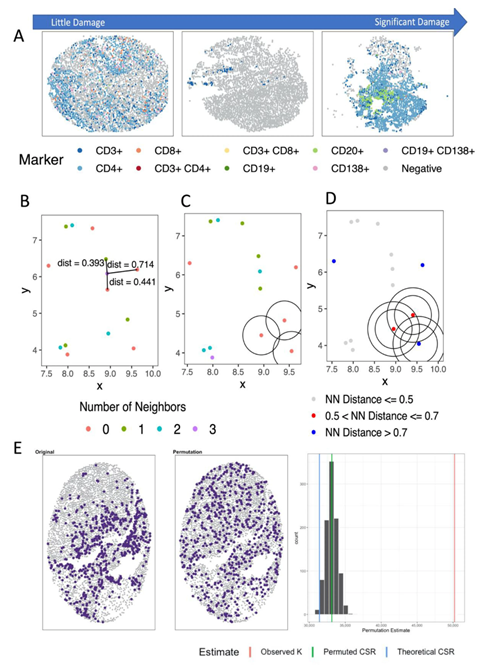
图4 mIF空间统计方法示意图
将图像切分为多个子区域,统计子区域内细胞组成,代表方法:
- Morisita‑Horn (MH) 指数:评估不同细胞群体的空间分散 / 共聚集。缺点:稀有细胞时估计偏差大;
- Duncan 隔离指数:判断细胞在子区域分布是否偏离随机;
- 沃罗诺伊图(Voronoi diagram):定义细胞直接邻域,计算细胞‑细胞邻接关系;在肺腺癌研究中,借助该方法发现 T 细胞高聚集与肿瘤低复发相关。
局限:这类方法来自生态学、社会学,大多没有考虑相邻子区域的空间自相关。
计算目标细胞距离另一类细胞的最短欧氏距离,是应用非常广泛的手段。例如胰腺癌研究观察到髓系细胞相比 T/B 细胞距离肿瘤细胞更近;黑色素瘤中肿瘤细胞增殖状态会改变细胞毒性淋巴细胞与肿瘤细胞的距离。
提醒:图像孔洞(无细胞空白区域)会扭曲最近邻距离结果,建议搭配置换 / 蒙特卡洛模拟校正偏差。
把每个细胞视作二维平面上的点,把整张切片视为观测窗口,检验细胞分布是否符合完全空间随机(CSR);偏离 CSR 提示细胞聚集(吸引)或者排斥分散。综述重点介绍一系列经典函数工具:
- Ripley’s K(r),衍生 L(r)、M(r):以细胞为圆心,半径 r 邻域内统计邻居细胞数量,判断聚集 / 分散;卵巢癌研究中发现:CD3+CD8 + 细胞丰度高但是聚集程度低的患者生存更好;
- G(r)(最近邻距离分布),F(r) 空白空间函数,配对相关函数 g(r)、J(r):描述不同距离尺度下细胞间相互作用;可以做双变量版本,评估两类不同细胞之间的空间互作,例如 Treg 细胞与肿瘤细胞、细胞毒性 T 细胞之间的距离关联生存结局;
- 边界校正:图像边缘细胞的一部分邻域落在切片外,会低估邻居数量,需要各向同性校正、平移校正等边缘校正策略;
- 函数型数据分析 FDA:K(r)、g(r) 是随半径 r 变化的一整条曲线,可以把整条曲线作为特征,而不是挑选单一 r 值,充分利用多尺度空间信息。
TMA 普遍存在组织孔洞,理论 CSR 解析公式会失效。综述强烈推荐置换 / 蒙特卡洛模拟生成图像特异性的零分布:在图像有效区域内随机置换细胞位置,模拟完全空间随机状态,得到统计量的经验零分布;用观测统计量减去置换模拟的均值,得到校正后的聚集程度指标。同时可以在肿瘤区域、基质区域分别做置换分析,区分不同微环境隔间的空间模式。
流程总结:原始观测统计量 − CSR 置换模拟均值 = 校正后的细胞聚集 / 共定位程度;再将该空间特征用于后续与生存、治疗响应的关联分析。并且需要校正细胞总丰度:聚集程度高有可能仅仅是细胞数量多导致,需要控制细胞丰度混杂。
这篇综述也提出 mIF 统计领域亟待攻克的方向,也是当前数字病理免疫组学的前沿研究热点:
- 多组学融合:将 mIF 空间细胞信息与单细胞 RNAseq、空间转录组联合分析,把蛋白原位空间分布和转录组分子状态互相印证;
- 免疫亚型综合分型模型:整合细胞丰度 + 空间架构,开发 “空间免疫评分”,类似免疫评分 (Immunoscore),同时兼容零膨胀、过离散、同一患者多次重复测量的数据特征;区分冷 / 热肿瘤,解析瘤内免疫异质性;
- 绕过细胞表型二分类判定,直接基于原始荧光强度开展统计建模,规避细胞表型错分带来的偏倚,但需要解决荧光强度批次归一化难题;
- 开发更完善的空间临床关联模型:把置换校正后的空间统计量纳入生存模型,挖掘可预测免疫治疗响应的空间生物标志物。
Wilson C M, Ospina O E, Townsend M K, et al. Challenges and Opportunities in the Statistical Analysis of Multiplex Immunofluorescence Data[J]. Cancers, 2021,13(12):3031. https://doi.org/10.3390/cancers13123031
EnkiLife mIF 技术服务
提供有偿代检和分析服务
承接多色配套服务
分类 | 服务项目 | 备注 |
|---|---|---|
IHC染色 | IHC单色标记 | |
IF荧光染色 | 免疫荧光单标 | 不含一抗,含二抗(兔/小鼠/大鼠)、DAPI。 四标以上染色需要提供多余白片做单标预实验。 |
荧光多标染色 | ||
全景扫描 | 免疫组化全景扫描 | 提供读片软件及原始相关文件,荧光扫描波长范围。 |
荧光标记全景扫描 | ||
数据分析 | 免疫组化及免疫荧光切片分析 | 可进行全片单阳性、多阳性细胞数及面积分析,也可定制分析特征病理区域,或进行空间分析、位置分析等。 |